A quadruped’s base motion continuously affects the accuracy of its mounted arm. This research studies continuous manipulation during walking, combining reinforcement learning and model predictive control for stable locomotion and end-effector tracking.
My contributions
Built a legged-manipulation benchmark, reproduced RoboDuet, UMI on Legs, and Visual WBC in Isaac Gym, and adapted them to the Unitree Go2 model.
Developed a unified MuJoCo evaluation environment with 50 end-effector SE(3) trajectories under nominal and external-disturbance conditions.
Evaluated tracking accuracy, task success, and stability, and contributed to experimental validation of ReCo against RL and MPC baselines.
Technical approach
Policy reproduction
Train and adapt multiple baselines on a common robot model.
Unified evaluation
Compare methods using consistent trajectories and disturbances.
Coordinated control
Validate the overall coordination of locomotion policies and arm MPC.
Outcomes & evaluation
50SE(3) evaluation trajectories
28.7%Lower position RMSE · paper result
27.4%Lower orientation RMSE · paper result
The research resulted in the ReCo manuscript, currently under review.
Overall method results reported in the paper show 28.7% lower position RMSE and 27.4% lower orientation RMSE relative to the best baseline for each metric.
The public paper demonstrates real-robot continuous manipulation for object organization, cabinet-door opening, and pick-and-place.
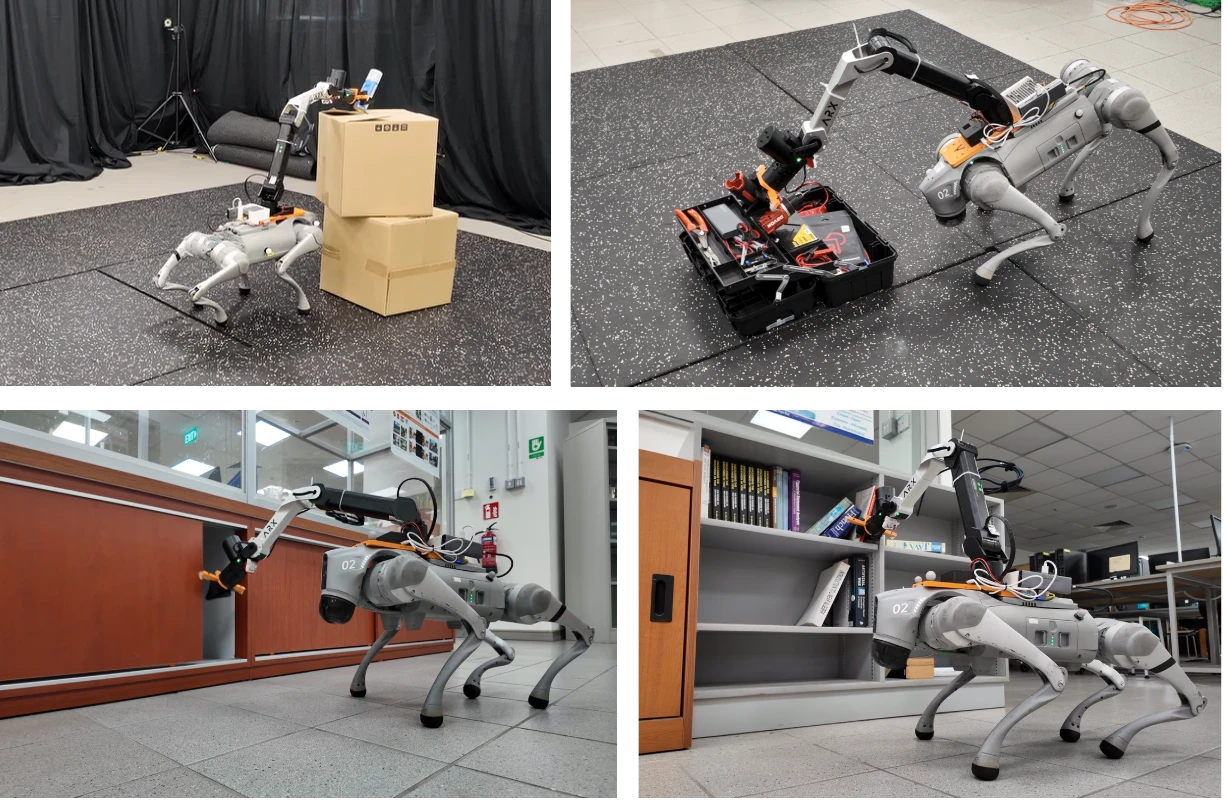 ReCo · Real-robot experiments